Auk TTS 文本转语音模型入门
AuK 是腾讯混元开源的一个拥有15亿(1.5B)参数的语音生成与编辑基础模型。该模型基于数百万小时的多样化音频数据进行训练,通过统一的自然语言指令接口,支持零样本和指令驱动的TTS、内容与声学编辑、副语言特征编辑、语音增强以及声源分离等功能。
在研究 Auk 的同时,也在研究哔哩哔哩开源的 IndexTTS, 他们产品定位是不同的:
- IndexTTS 是专精于“合成得更像、更可控”的 TTS 模型,必须输入参考语音,然后把文本变成高质量语音。
- AuK 是一个以自然语言指令驱动、覆盖从生成到后期编辑全链路的“语音基础模型”,用一句话指令对语音做几乎任何事(对于语音的增删改查)。
AuK 核心能力/特点:
- 语音生成。支持零样本 TTS 和指令 TTS。
- 零样本 TTS :用参考音频的音色朗读目标文本。
- 指令 TTS :无需参考音频,仅根据声音描述生成语音。
- 语音编辑。支持对于一段语音进行编辑修改
- 内容编辑: 重写所说的内容:替换 / 插入 / 删除。
- 歌词编辑: 在演唱录音中重写歌词,同时保留旋律和音色。
- 音高编辑: 按半音升高/降低音高;输出等长。
- 语速编辑: 调整语速;输出长度随速度因子缩放
- 音量编辑: 按分贝升高/降低音量;输出等长。
- 情感编辑: 改变情感,同时保留内容和音色;输出等长。
- 音色编辑: 保持所说内容不变,将音色改为描述的声音。
- 去口音: 去除地区口音,同时保留说话人音色和内容;输出等长。
- 非言语编辑:删除或添加呼吸声、笑声、咳嗽声等非言语声音。
- 耳语转换: 在正常语音 ↔ 耳语之间转换,同时保留说话人和内容;输出等长。
- 语音增强: 降噪 / 去混响 / 完整增强 / 音质修复。
- 语音分离: 按说话顺序保留一位说话人,去除其他说话人。
- 音乐分离: 从混音中提取歌声,或保留所有人声。
- 目标说话人提取: 根据所说内容定位并保留目标说话人,去除其他说话人。
AuK有两个版本:
- AuK:用于高质量生成的基础模型
- AuK-Flash:经过蒸馏,支持4 步推理,在相同条件下实际运行速度比基础版快 4.5 倍,更适合对实时性有要求的部署场景。
Auk 环境安装
Auk 的安装方式取决于你的硬件平台和使用场景,官方主要面向 NVIDIA GPU (CUDA) 环境。 非 GPU 或 Mac 环境运行效率会比较低, 但也可以通过 CPU 来运行。
1. 准备运行的 Python 环境
如果需要进行环境隔离,可以使用 venv 方式, 官方推荐使用 uv 工具。
在 Auk 项目目录中执行
# Create and activate a project-local environment.
uv venv --python 3.10
source .venv/bin/activate
2. Pypi 国内镜像加速
直接访问 Pypi 官网的网络速度可能和慢,国内加速可以使用阿里云镜像源。
添加或修改配置文件 ~/.config/uv/uv.toml
[[index]]
url = "http://mirrors.aliyun.com/pypi/simple/"
default = true
或者使用环境变量,可固化到 ~/.bashrc 或 ~/.zshrc
export UV_DEFAULT_INDEX="https://pypi.tuna.tsinghua.edu.cn/simple"
3. 安装 AuK
Auk 相关软件和依赖的安装一般通过源码仓库的方式安装,获取源码
git clone https://github.com/Tencent-Hunyuan/AuK.git
在 AuK 代码目录安装依赖
cd Auk

# Choose one installation target:
# Core inference and CLI only
uv pip install -e .
4. 下载模型权重
Auk 运行时需要额外加载 Qwen2.5-Omni-3B 作为指令理解模块,再配合 Auk 自身的扩散 Transformer 和 VAE 来生成音频。因此,者两个模型都需要下载。
并且,Auk 在运行时有个默认的模型路径,位于代码的根目录。
modelscope download --model Tencent-Hunyuan/AuK-Flash  --local_dir ./ckpts/AuK-Flash
modelscope download --model Qwen/Qwen2.5-Omni-3B --local_dir ./ckpts/Qwen2.5-Omni-3B
下载完成后的模型路径:
Auk
├── ckpts
│   ├── AuK-Flash  # 或 AuK/
│   ├── Qwen2.5-Omni-3B
├── .env
├── src
... ...
5. 准备大模型调用的环境变量 .env 文件
AuK 的某些工作流节点(如 AuK Generate)附带了一个“提示词增强器” (src/auk/infer/pe.py 命令)。它的作用是把你随口说的、不规整的请求,自动分类成 AuK 能理解的任务类型,并改写成标准格式。这个增强过程本质上是一次聊天补全(Chat Completions) 调用,因此需要一个大模型来执行。如果你在节点里启用了这个增强器,就必须提供一个可访问的 LLM 接口,否则工作流会报错或无法生成理想结果。
基于环境变量的方式获取模型凭证
# DeepSeek V4 Flash (alternative)
export LLM_API_KEY=sk-f1e5*****************6a
export LLM_BASE_URL=https://api.deepseek.com
export LLM_MODEL_NAME=deepseek-v4-flash
至此,Auk 环境就准备就绪了。
AuK 根据声音描述生成语音
无需参考音频,仅根据声音描述生成语音,又叫指令 TTS。
英文:Generate speech based on the following description: “{voice description}”. The content to speak is: “{text}”.
中文:请基于下面的描述: “{声音描述}",生成语音内容”{文本}".
指令 TTS 没有参考音频,因此省略 --audio,并用 --gen_seconds 设置目标长度。
声音的目标长度会影响语速,可以调整声音长度多执行几次,或者使用下文提示词增强器来自动生成 auk-infer 命令和时长。
如果使用flash 模型,需要指定 --ckpt 参数
auk-infer \
    --instruction 'Based on the following description: "一位二十多岁的女性新闻播报员,国家级播音腔,明亮圆润的中音实声、字正腔圆的零口音普通话、语速适中、句尾降调的客观庄重语气。节奏上强调字正腔圆、句读分明。语气上保持客观、庄重、中性,不流露个人情绪。情感基调是庄重、大气、可信。", generate speech content "大家好,今天是二零二六年十一月十六日,星期一,这里是常云阁AI实验室,下面用五分钟快速了解昨天科技圈值得关注的事。"' \
    --ckpt ckpts/AuK-Flash/auk_flash.safetensors \
    --output out_instruct_tts.wav \
    --gen_seconds 11
生成的语音如下:
我这里生成的结果中有点小瑕疵,第一秒的内容混乱,可以借助 ffmpeg 工具进行截取
ffmpeg -i input.wav -ss 00:00:01 -t 11 -c copy output.wav
从第 1 秒开始,截取 11 秒
-ss起始时间-t截取时长-c copy直接复制音频流,速度快、无损(WAV 用 copy 没问题)。
Auk 基于参考音色输出语音
每次都基于 指令 TTS 生成语音在不同参数和、场景或版本中可能音色会有差异,就像不同的人说话。因此,我基于 指令 TTS 先生成一段参考语音,然后基于参考语音生进行长文本语音生成。
对长内容语音生成,可以使用 提示词增强器 来自动生成 auk-infer 命令和时长。它将你提供的音频和一句自然语言指令,自动翻译成一条完整、可直接执行的 auk-infer 命令,并生成一份任务配置文件(manifest),从而简化手动挑选参数的过程。6注意:该过程需要 AI 大模型的推理,请先准备好大模型环境变量(参考 5. 准备大模型调用的环境变量 .env 文件)。
(.python-venv) zhaowenyu@zhaowenyudeMacBook-Pro AuK % source .env
(.python-venv) zhaowenyu@zhaowenyudeMacBook-Pro AuK % python src/auk/infer/pe.py \
  --audio example1.wav \
  --instruction "请生成语音内容: DeepSeek 把自家应用里的那套交互能力整体开放成了接口。开发者打开对应参数,就能拿到联网搜索、深度思考搜索、文件输入、阅读链接和模型安全校验,工具调用和上下文拼接都由服务端完成。搜索和抓取按每千次五元计费,文件解析和图片识别按每千页零点二二五美元,语音合成和识别也单独标了价。". \
  --asr auto
Task: zero_shot_tts
Original instruction: 请生成语音内容: DeepSeek 把自家应用里的那套交互能力整体开放成了接口。开发者打开对应参数,就能拿到联网搜索、深度思考搜索、文件输入、阅读链接和模型安全校验,工具调用和上下文拼接都由服务端完成。搜索和抓取按每千次五元计费,文件解析和图片识别按每千页零点二二五美元,语音合成和识别也单独标了价。.
PE instruction: Say the following with the same voice: "DeepSeek 把自家应用里的那套交互能力整体开放成了接口。开发者打开对应参数,就能拿到联网搜索、深度思考搜索、文件输入、阅读链接和模型安全校验,工具调用和上下文拼接都由服务端完成。搜索和抓取按每千次五元计费,文件解析和图片识别按每千页零点二二五美元,语音合成和识别也单独标了价。"
Target duration: 32.38 s
Model input audio: example1.wav
Manifest: assets/after_pe/example1.pe.json
Inference command:
auk-infer \
  --audio example1.wav \
  --ckpt ckpts/AuK-Flash/auk_flash.safetensors \
  --instruction 'Say the following with the same voice: "DeepSeek 把自家应用里的那套交互能力整体开放成了接口。开发者打开对应参数,就能拿到联网搜索、深度思考搜索、文件输入、阅读链接和模型安全校验,工具调用和上下文拼接都由服务端完成。搜索和抓取按每千次五元计费,文件解析和图片识别按每千页零点二二五美元,语音合成和识别也单独标了价。"' \
  --output assets/after_pe/example1.output.wav \
  --gen_seconds 32.379999999999995
在最下面就是生成的 auk-infer 命令,可以直接复制执行。
如果使用 Auk-Flash 模型,需要指定 --ckpt 参数: --ckpt ckpts/AuK-Flash/auk_flash.safetensors
 % auk-infer \
  --audio example1.wav \
  --ckpt ckpts/AuK-Flash/auk_flash.safetensors \
  --instruction 'Say the following with the same voice: "DeepSeek 把自家应用里的那套交互能力整体开放成了接口。开发者打开对应参数,就能拿到联网搜索、深度思考搜索、文件输入、阅读链接和模型安全校验,工具调用和上下文拼接都由服务端完成。搜索和抓取按每千次五元计费,文件解析和图片识别按每千页零点二二五美元,语音合成和识别也单独标了价。"' \
  --output assets/after_pe/example1.output.wav \
  --gen_seconds 32.379999999999995
2026-11-18 12:55:49,296 - INFO - Detected AuK-Flash release — locking sampling to the 4-step / CFG-off recipe.
2026-11-18 12:55:49,296 - INFO - Loading Qwen text encoder from ckpts/Qwen2.5-Omni-3B ...
`torch_dtype` is deprecated! Use `dtype` instead!
Unrecognized keys in `rope_scaling` for 'rope_type'='default': {'mrope_section'}
Loading checkpoint shards: 100%|████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████| 3/3 [00:00<00:00,  9.37it/s]
The image processor of type `Qwen2VLImageProcessor` is now loaded as a fast processor by default, even if the model checkpoint was saved with a slow processor. This is a breaking change and may produce slightly different outputs. To continue using the slow processor, instantiate this class with `use_fast=False`. Note that this behavior will be extended to all models in a future release.
2026-11-18 12:55:49,995 - INFO - Loading VAE from /Users/zhaowenyu/code/cncfstack-ai/text-to-voice/AuK/ckpts/AuK-Flash/vae.safetensors ...
2026-11-18 12:55:49,998 - INFO - BigVGANFlowVAE Config:
2026-11-18 12:55:49,998 - INFO -   upsample_rates: [5, 4, 3, 2, 2, 2]
2026-11-18 12:55:49,998 - INFO -   upsample_kernel_sizes: [10, 8, 6, 4, 4, 4]
2026-11-18 12:55:49,998 - INFO -   upsample_initial_channel: 1536
2026-11-18 12:55:49,998 - INFO -   resblock_kernel_sizes: [3, 7, 11]
2026-11-18 12:55:49,998 - INFO -   resblock_dilation_sizes: [[1, 3, 5], [1, 3, 5], [1, 3, 5]]
2026-11-18 12:55:49,998 - INFO -   downsample_rates: [2, 2, 2, 3, 4, 5]
2026-11-18 12:55:49,998 - INFO -   downsample_channels: [12, 24, 48, 96, 192, 384, 768]
2026-11-18 12:55:49,999 - INFO -   snake_logscale: True
2026-11-18 12:55:49,999 - INFO -   latent_dim: 64
2026-11-18 12:55:49,999 - INFO -   use_vae: True
2026-11-18 12:55:49,999 - INFO -   causal: True
2026-11-18 12:55:49,999 - INFO -   flow_hidden_channels: 256
2026-11-18 12:55:49,999 - INFO -   act_causal: True
/Users/zhaowenyu/.python-venv/lib/python3.13/site-packages/torch/nn/utils/weight_norm.py:143: FutureWarning: `torch.nn.utils.weight_norm` is deprecated in favor of `torch.nn.utils.parametrizations.weight_norm`.
  WeightNorm.apply(module, name, dim)
2026-11-18 12:55:52,132 - INFO - Building CFMEdit model ...
2026-11-18 12:55:54,685 - INFO - Loading model checkpoint from ckpts/AuK-Flash/auk_flash.safetensors ...
2026-11-18 12:56:08,155 - INFO - Loaded EMA weights | missing=924 (text_encoder.*=924, other=0) | unexpected=0
Saved output -> assets/after_pe/example1.output.wav  (32.38s @ 24000 Hz)
生成的语音如下:
语音编辑
语音的生成与编辑都是基于 auk-infer 指令处理,主要差异就是 --instruction 参数的描述不同,但也有一些参考模板可以使用。
完整的 Auk 介说明 https://github.com/Tencent-Hunyuan/AuK/blob/main/docs/COOKBOOK.md
- 中文:请基于下面的描述: “{声音描述}",生成语音内容”{文本}".
- 中文:把’{原文}‘改成’{新文}’
- 中文:在’{锚点}‘前面加上’{内容}’ | 在’{锚点}‘后面加上’{内容}’
- 中文:删掉’{内容}’ | 删掉’{锚点}‘前/后面的’{内容}’
- 中文:把这段歌词中的"{原歌词}“改成”{新歌词}"。
- 中文:将音调升高{1/2/3}个半音。 | 将音调降低{1/2/3}个半音。
- 中文:将语速调整为{0.5/0.75/1.25/1.5/2.0}倍。
- 中文:将音量升高{5/10/15}分贝。 | 将音量降低{5/10/15}分贝。
- 中文:将情感转变为{开心/愤怒/悲伤/恐惧/惊讶/厌恶/平静/兴奋}。
- 中文:请将这段音频的音色修改为符合以下描述的声音:"’{音色描述}’"。
- 中文:请去掉这段语音里的方言口音,保持说话人音色一致。
- 中文:删除音频中所有的{换气声/笑声/咳嗽声等}。
- 中文:在语音{开头/结尾}增加{声音}。
- 中文:用小声耳语的方式把这段话说出来。
- 中文:把这段耳语转换成正常说话的声音。
- 中文:请只去除背景噪声,保留其他内容,输出等长结果。
- 中文:请只去除房间混响,保留其他内容,输出等长结果。
- 中文:请保留所有说话人,去除噪声和混响,输出等长的纯净语音。
- 中文:请修复这段音频的{电话感/闷声/削波/丢包},恢复自然清晰的人声。
- 中文:只保留第{序号}个开始说话的人,去掉其余说话人。
- 中文:请只保留歌声,其余声音都去掉。
- 中文:请保留所有人声,包括说话和歌唱,其余声音都去掉。
- 中文:请只保留说"{内容}“的人,去掉其他说话人。
Python API 设置
初始化 AuK 一次,并在下面的示例中复用 run_auk(...)。纯文本指令 TTS 无需设置 audio_path。
from auk.infer.infer_auk import AukInfer, save_audio

checkpoint = "ckpts/AuK/auk_base.safetensors"
config = "ckpts/AuK/config.yaml"

# 改用 AuK-Flash:
# checkpoint = "ckpts/AuK-Flash/auk_flash.safetensors"
# config = "ckpts/AuK-Flash/config.yaml"

engine = AukInfer(
    config,
    checkpoint,
)


def run_auk(
    instruction,
    output_path,
    audio_path=None,
    gen_seconds=None,
):
    content = [{"type": "text", "text": instruction}]

    if audio_path is not None:
        content.append({"type": "audio", "audio": audio_path})

    messages = [
        {
            "role": "user",
            "content": content,
        }
    ]

    audio, sr = engine.generate(
        messages,
        gen_seconds=gen_seconds,
    )
    save_audio(audio, sr, output_path)
当任务需要显式指定输出时长时(例如 TTS、内容编辑或语速编辑),请传入 gen_seconds。对于保持源时长的任务,可以省略。
Web 页面
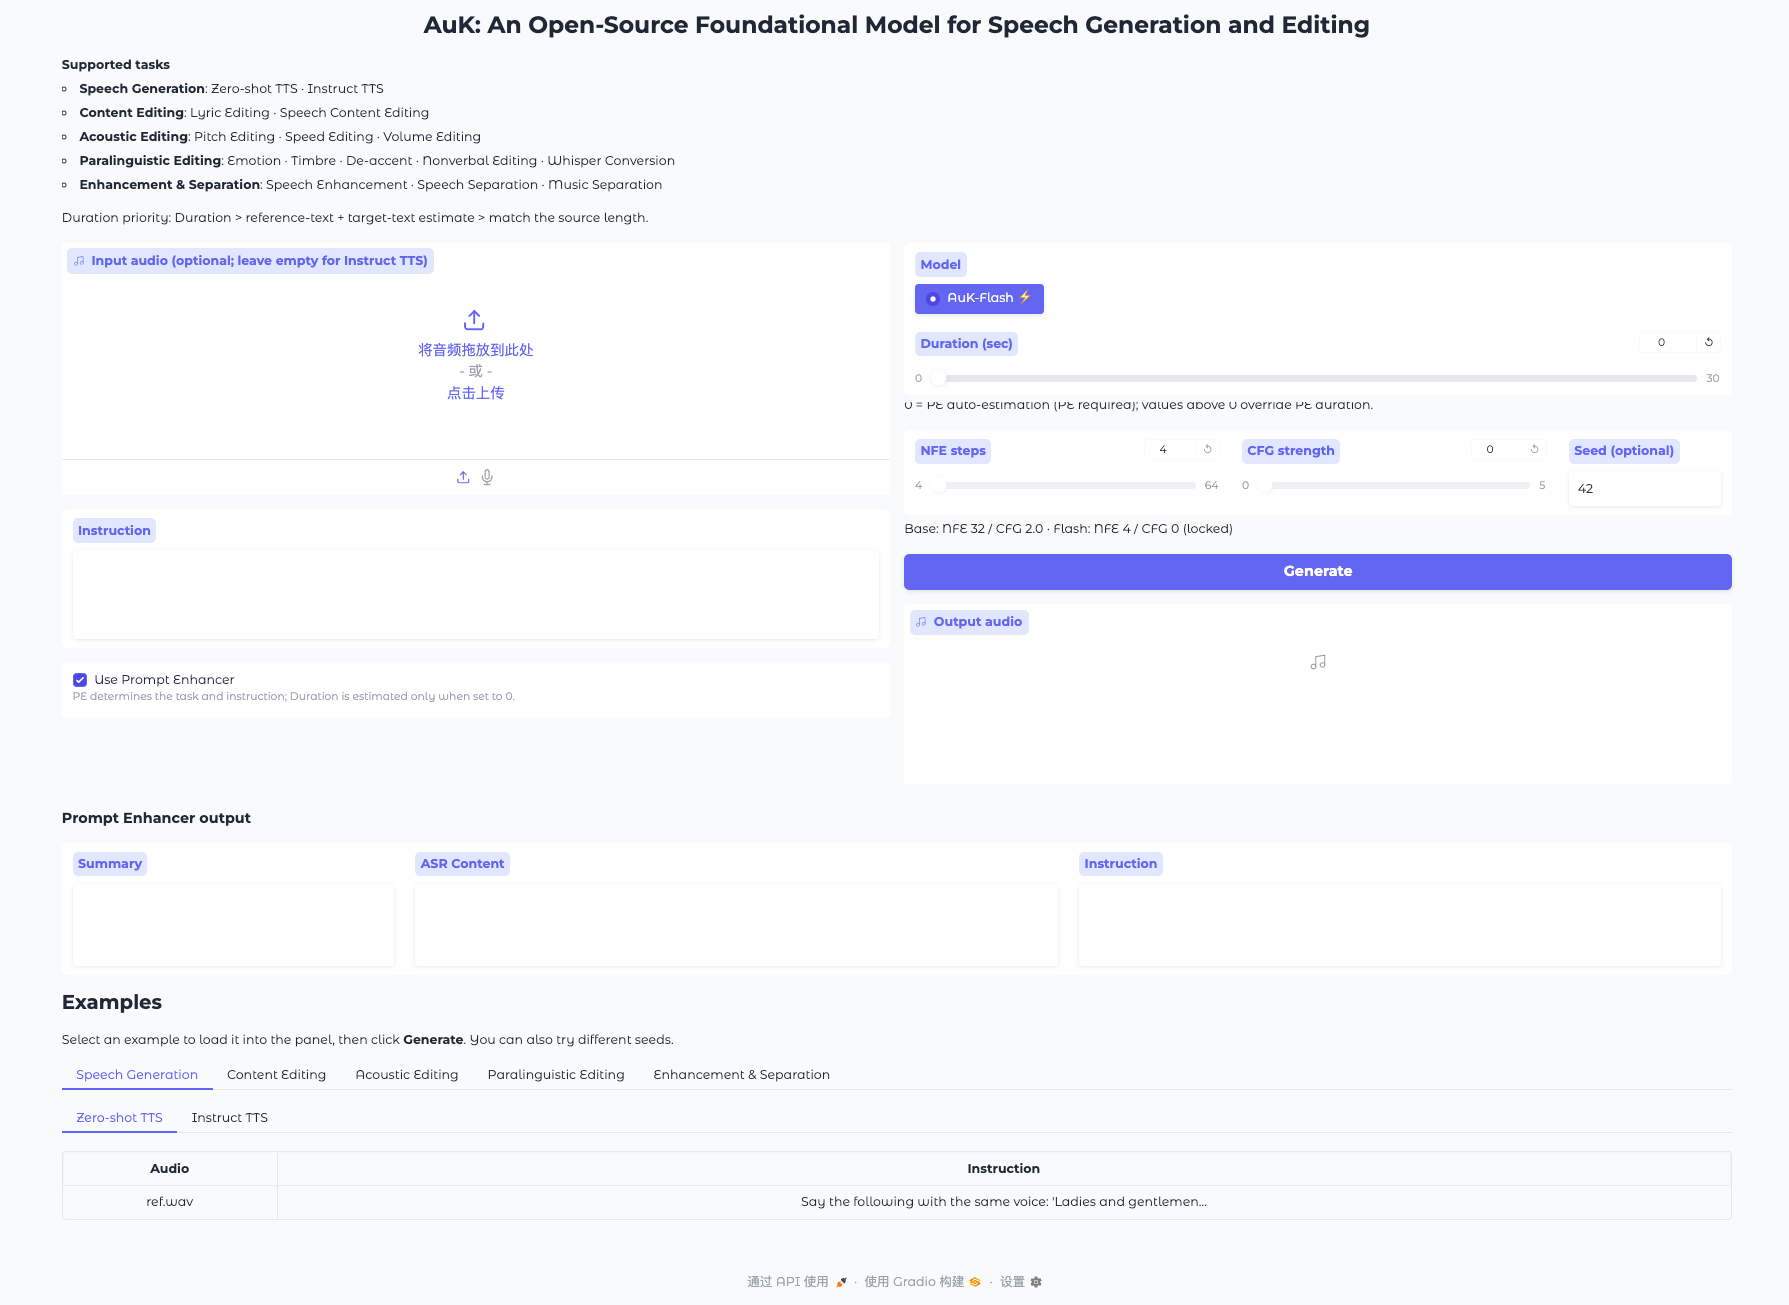
项目自带了一个 Web 页面,可以直接在浏览器中使用。
需要先安装依赖
# Core inference + Gradio + Prompt Enhancer + ASR
uv pip install -e ".[gradio]"
安装成功后,启动 Web 页面。
source .env
auk-gradio \
  --flash_ckpt ckpts/AuK-Flash/auk_flash.safetensors \
  --flash_config ckpts/AuK-Flash/config.yaml \
  --qwen_path ckpts/Qwen2.5-Omni-3B \
  --host 0.0.0.0 \
  --port 8080 \
  --preload
这里只使用 Auk-Flash 模型,如果需要同时使用 Auk-Base 模型,需要指定参数: --base_ckpt ckpts/AuK/auk_base.safetensors 和
--base_config ckpts/AuK/config.yaml
如果有 GPU,可以通过 --base_device cuda:0 和 --flash_device cuda:0 指定使用 GPU 进行推理。
如果是 Mac 系统,可能还需要安装 OpenFst。 因为安装过程依赖的 pynini 不是纯 Python 包,它依赖系统中的 OpenFst C++ 库才能编译安装
brew install openfst
或者使用环境变量,可固化到 ~/.bashrc 或 ~/.zshrc
# 设置头文件路径
export CPLUS_INCLUDE_PATH="/opt/homebrew/include:$CPLUS_INCLUDE_PATH"
# 设置库文件路径
export LIBRARY_PATH="/opt/homebrew/lib:$LIBRARY_PATH"
# 设置运行时动态链接库路径
export LD_LIBRARY_PATH="/opt/homebrew/lib:$LD_LIBRARY_PATH"
总结
Auk 是一个强大的语音生成和编辑模型,在语音处理方面的能力很强大。但是对于“文本生成语音”场景,感觉相对较重,可以基于 Auk 生成参考音色后,基于该音色选择更轻量的语音生成模型。